Python 文件操作实战:高效读写文件与 CSV/JSON 处理详解
引言:文件操作的价值
适合读者:掌握了函数和列表字典的 Python 入门开发者。
一个 10 万行的 Nginx 访问日志,筛出所有状态码为 500 的请求行,按 URL 分组统计次数,再把结果写成 JSON 报告——不用 Excel,不用数据库,一个 Python 脚本搞定,运行时间不到一秒。
这就是文件操作的实际价值所在。数据不可能永远活在内存里,程序的输入来自文件,输出也要写回文件,两者之间的这段代码就是文件操作的核心。
本篇用一个日志分析器作为贯穿场景,从最基础的 open() 函数讲起,覆盖文本读写、CSV、JSON、路径处理,以及几个在生产代码里真正会踩的坑。
一、文件读写基础
1.1 open() 函数与三种模式
Python 用内置的 open() 函数打开文件,最重要的两个参数是路径和模式:
# 读取文件(默认模式,文件不存在会报 FileNotFoundError)
file = open("access.log", "r")

# 写入文件(会覆盖原有内容,文件不存在则创建)
file = open("output.txt", "w")

# 追加内容(不覆盖,在原有内容末尾继续写)
file = open("output.txt", "a")
三种模式的行为差异:
"r":文件存在时正常打开,不存在则报FileNotFoundError,常见场景为读取配置、日志。"w":文件存在时清空重写,不存在则自动创建,常见场景为生成报告、输出结果。"a":文件存在时追加写入,不存在则自动创建,常见场景为追加日志、增量输出。
处理二进制文件:图片、PDF 等二进制文件需要加 "b" 模式(如 "rb", "wb"),本篇聚焦文本文件。
1.2 with open():正确的文件打开姿势
手动 open() 的问题是:如果读取过程中程序崩溃,文件句柄就不会被关闭,长期运行的程序会耗尽系统的文件描述符。
with 语句解决了这个问题:
# 推荐写法:with 语句保证文件一定被关闭
with open("access.log", "r", encoding="utf-8") as f:
    content = f.read()
# 离开 with 代码块后,f 自动关闭,无论是否有异常

# 不推荐写法:需要手动 close(),一旦出错容易忘记
f = open("access.log", "r", encoding="utf-8")
content = f.read()
f.close()  # 如果 read() 出错,这行就执行不到
with 语句背后用的是 Python 的上下文管理器协议——文件对象实现了 __enter__ 和 __exit__ 方法,with 块结束时会自动调用 __exit__,无论是否发生异常都会执行关闭操作。
encoding 参数不要省略:不同操作系统的默认编码不同(Windows 是 GBK,Linux/macOS 是 UTF-8),省略 encoding 会导致代码在不同环境下行为不一致。
1.3 四种读取方式:如何选择
打开文件之后,有四种方式读取内容,选错了会直接影响内存占用:
with open("access.log", "r", encoding="utf-8") as f:
    # 方式1:read() — 一次性读取全部内容,返回字符串
    content = f.read()
    # 适合:小文件(< 几十 MB),需要整体处理

    # 方式2:readline() — 每次读取一行,返回字符串(含 n)
    line = f.readline()
    # 适合:需要手动控制读取进度的场景

    # 方式3:readlines() — 一次性读取所有行,返回列表
    lines = f.readlines()
    # 适合:小文件,需要按行处理并保留所有行

    # 方式4:for line in f — 逐行迭代(推荐)
    for line in f:
        process(line)
    # 适合:大文件(按需读取,内存友好)
内存开销对比:
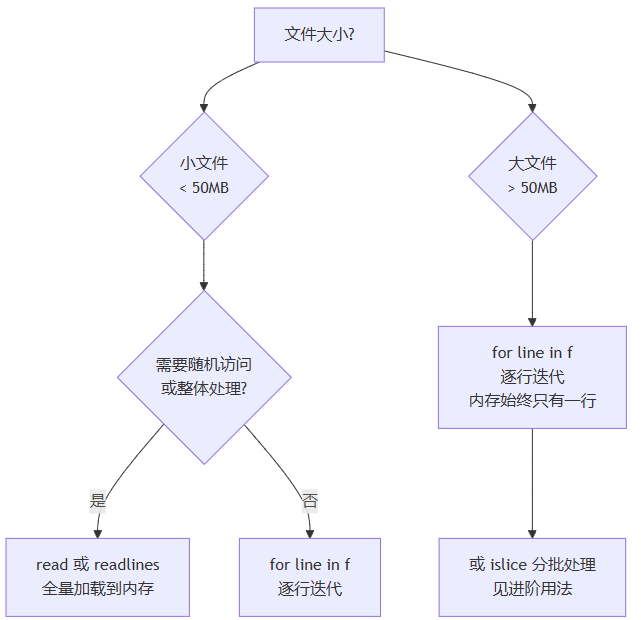
实际经验:一个 500MB 的日志文件,read() 需要占用约 500MB 内存,for line in f 的内存占用始终不超过一行的大小(通常几百字节)。
二、写入文件
2.1 write() 与 writelines()
# write():写入一个字符串,返回写入的字符数
with open("output.txt", "w", encoding="utf-8") as f:
    f.write("第一行n")        # n 换行符需要手动添加
    f.write("第二行n")
    count = f.write("第三行n")
    print(count)               # 输出写入的字符数

# writelines():写入字符串列表,不自动添加换行符
lines = ["第一行n", "第二行n", "第三行n"]
with open("output.txt", "w", encoding="utf-8") as f:
f.writelines(lines)两者的区别只有一个:writelines() 接受可迭代对象,但不会自动在每个元素后面添加换行符,换行符需要包含在每个字符串里。
2.2 追加写入
"a" 模式在文件末尾继续写入,不覆盖原有内容:
def append_log(message):
    """追加一条日志记录"""
    import datetime
    timestamp = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    with open("app.log", "a", encoding="utf-8") as f:
        f.write(f"[{timestamp}] {message}n")

append_log("用户登录成功")
append_log("查询请求处理完成")
# 每次调用都在 app.log 末尾追加一行
三、CSV 文件读写
CSV(Comma-Separated Values)是最常见的表格数据格式,Python 内置了 csv 模块处理它。
3.1 读取 CSV
import csv

# 读取 CSV 文件,每行返回一个列表
with open("students.csv", "r", encoding="utf-8") as f:
    reader = csv.reader(f)
    header = next(reader)    # 第一行通常是表头
    print("字段名:", header)  # ['姓名', '分数', '班级']
    for row in reader:
        print(row)            # ['张三', '92', '高一甲班']
更推荐的方式是用 DictReader,把每行转成字典,直接用字段名取值:
import csv

with open("students.csv", "r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        # row 是一个字典:{'姓名': '张三', '分数': '92', '班级': '高一甲班'}
        name = row["姓名"]
        score = int(row["分数"])   # CSV 里数字是字符串,需要手动转换
        print(f"{name}: {score} 分")
3.2 写入 CSV
import csv

students = [
    {"姓名": "张三", "分数": 92, "班级": "高一甲班"},
    {"姓名": "李四", "分数": 87, "班级": "高一乙班"},
    {"姓名": "王五", "分数": 95, "班级": "高一甲班"},
]

with open("output.csv", "w", encoding="utf-8-sig", newline="") as f:
    fieldnames = ["姓名", "分数", "班级"]
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()   # 写入表头行
    writer.writerows(students)
3.3 编码坑:utf-8 vs utf-8-sig
这是 CSV 处理最常见的坑:
# 写入时用 utf-8
with open("output.csv", "w", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["姓名", "分数"])
# 用 Excel 打开:第一列显示 "锘縿名" 或乱码

# 写入时用 utf-8-sig(BOM 标记版本)
with open("output.csv", "w", encoding="utf-8-sig") as f:
    writer = csv.writer(f)
    writer.writerow(["姓名", "分数"])
# 用 Excel 打开:正常显示中文
原因:Excel 打开 CSV 文件时会检查文件开头是否有 BOM(Byte Order Mark,字节顺序标记)。utf-8-sig 编码在文件开头写入 BOM(xefxbbxbf),告诉 Excel 这是 UTF-8 文件,Excel 就能正确识别中文。
规则:
- 程序读/写,不涉及 Excel:用
utf-8 - 需要 Excel 打开中文 CSV:写入用
utf-8-sig,读取时utf-8和utf-8-sig都能正确读取
<img alt="CSV 编码问题示意图" height="595" src="/uploadfile/2026/1010/$1
原文链接:本站整理
本文来自互联网用户投稿,该文章观点仅代表作者本人,不代表本站立场。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如若内容造成侵权/违法违规/事实不符,请将相关资料发送至 service@2cto.cc 进行投诉反馈,一经查实,立即处理!
您可能感兴趣的文章:
下一篇:Python执行多行cmd命令:单&与双&&的区别详解